
Уявіть ситуацію: вранці панель керування хостингом зустрічає сповіщенням про помилку доступності, а самі сторінки відкриваються з відчутною затримкою. Статистика при цьому мовчить, рекламні кампанії не крутяться, а сплеску реальних відвідувачів немає. З високою ймовірністю причина криється в невидимих візитерах – ботах, які сканують вміст для навчання нейромереж.
Про яку саме інфраструктуру йдеться
Оренда віртуального хостингу чи VPS – це завжди чіткий набір обчислювальних ресурсів: процесорний час, оперативна пам’ять, швидкість дискової системи та щомісячний ліміт мережевого трафіку.
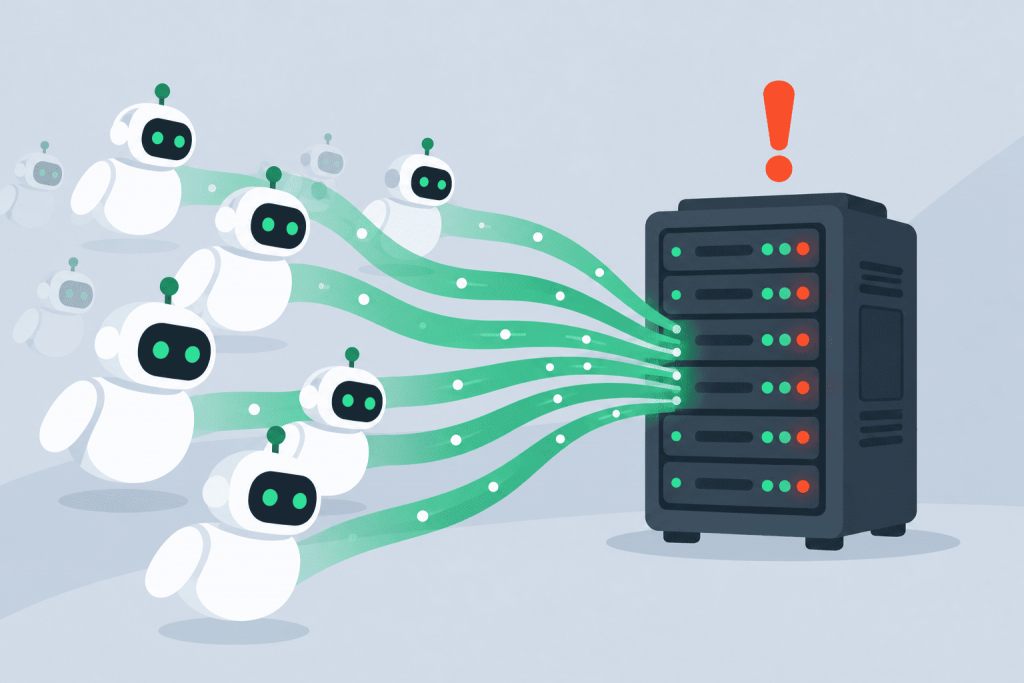
Саме ця інфраструктура потрапляє під удар AI-краулерів. Скрипти проганяють через себе тисячі сторінок, витягуючи тексти, графіку та бази товарів. Для самого сервера така активність виглядає як раптовий наплив користувачів, тільки от ці «гості» не створюють замовлень, зате справно спалюють реальні потужності.
Навантаження на процесор та оперативну пам’ять
Проблема не стільки у викачуванні статичних файлів, скільки в тому, як саме робоче сміття завантажує систему. Боти активно смикають внутрішній пошук, клацають по складних фільтрах каталогів і звертаються до динамічних елементів. Кожен такий запит піднімає з дна бази даних важкі вибірки.
Коли на сайт одночасно заходить десяток подібних парсерів, оперативна пам’ять забивається тимчасовими процесами, а процесор працює на критичній межі у 100% навантаження. Як результат – звичайні покупці годинами чекають на завантаження сторінки або отримують розрив з’єднання.
Вичерпання ресурсів баз даних та файлової системи
Найбільше від м’ясорубки штучного інтелекту дістається інтернет-магазинам та контентним проєктам. База даних MySQL чи PostgreSQL має фізичне обмеження на кількість одночасних з’єднань. AI-сканери здатні вичерпати цей ліміт буквально за пару секунд.
У цей момент на сайті падає все, що зав’язане на динаміку: кошик, форма оформлення замовлення, особистий кабінет. Паралельно диск починає безперервно зчитувати блоки даних для відправки роботам, що остаточно гальмує роботу всієї системи.
Перевищення лімітів трафіку та зайві витрати
Автоматизований скрапінг виїдає мережевий канал значно швидше за реальних людей. Роботи забирають сторінки «як є» – разом із картинками в високій роздільності та медіафайлами.
Якщо на тарифі стоїть обмеження по трафіку, ліміт вичерпається за дні. Далі – або додаткові рахунки від провайдера за кожен понадлімітний гігабайт, або раптова зупинка сервера. Виходить абсурдна ситуація: купувати дорожчий план доводиться не заради зростання продажів, а щоб прогодувати чужих ботів.
Ризики для контенту та SEO
Окрім технічної сторони, є ще й маркетингова. Витягуючи тексти, огляди чи картки товарів, ШІ-моделі забирають інтелектуальну власність у свої бази знань. У результаті чат-боти видають відповіді на основі цих даних, але не дають жодного посилання на першоджерело.
Паралельно страждає звичайний пошуковий трафік. Алгоритми Google чітко фіксують швидкість відгуку сервера. Якщо через набіги ботів сайт регулярно видає помилки або довго вантажиться, позиції у видачі почнуть просто повзти вниз.
Як захистити сервер від неконтрольованого скрапінгу
Покладатися на файл robots.txt зараз немає сенсу: більшість розробників штучного інтелекту ігнорують заборонні директиви. Реальний захист працює тільки на рівні серверних конфігурацій.
Найпростіший і найдієвіший крок – налаштування Rate Limiting. Це правило обмежує кількість запитів з однієї IP-адреси за секунду. Людина фізично не може відкривати по п’ятдесят сторінок за мить, тому система зрізає тільки автоматизовані скрипти.
Також допомагає фільтрація на рівні Nginx або Apache. Достатньо внести відомі підписи AI-ботів у список блокування за User-Agent, щоб сервер відкидав такі з’єднання ще на вході. Для комплексного захисту краще підключити фаєрвол WAF: він аналізує поведінку трафіку й відсікає підозрілих роботів до того, як вони дістануться до бази даних.
Залишити відповідь